Der Kristijan Jurčić Podcast, Folge 22
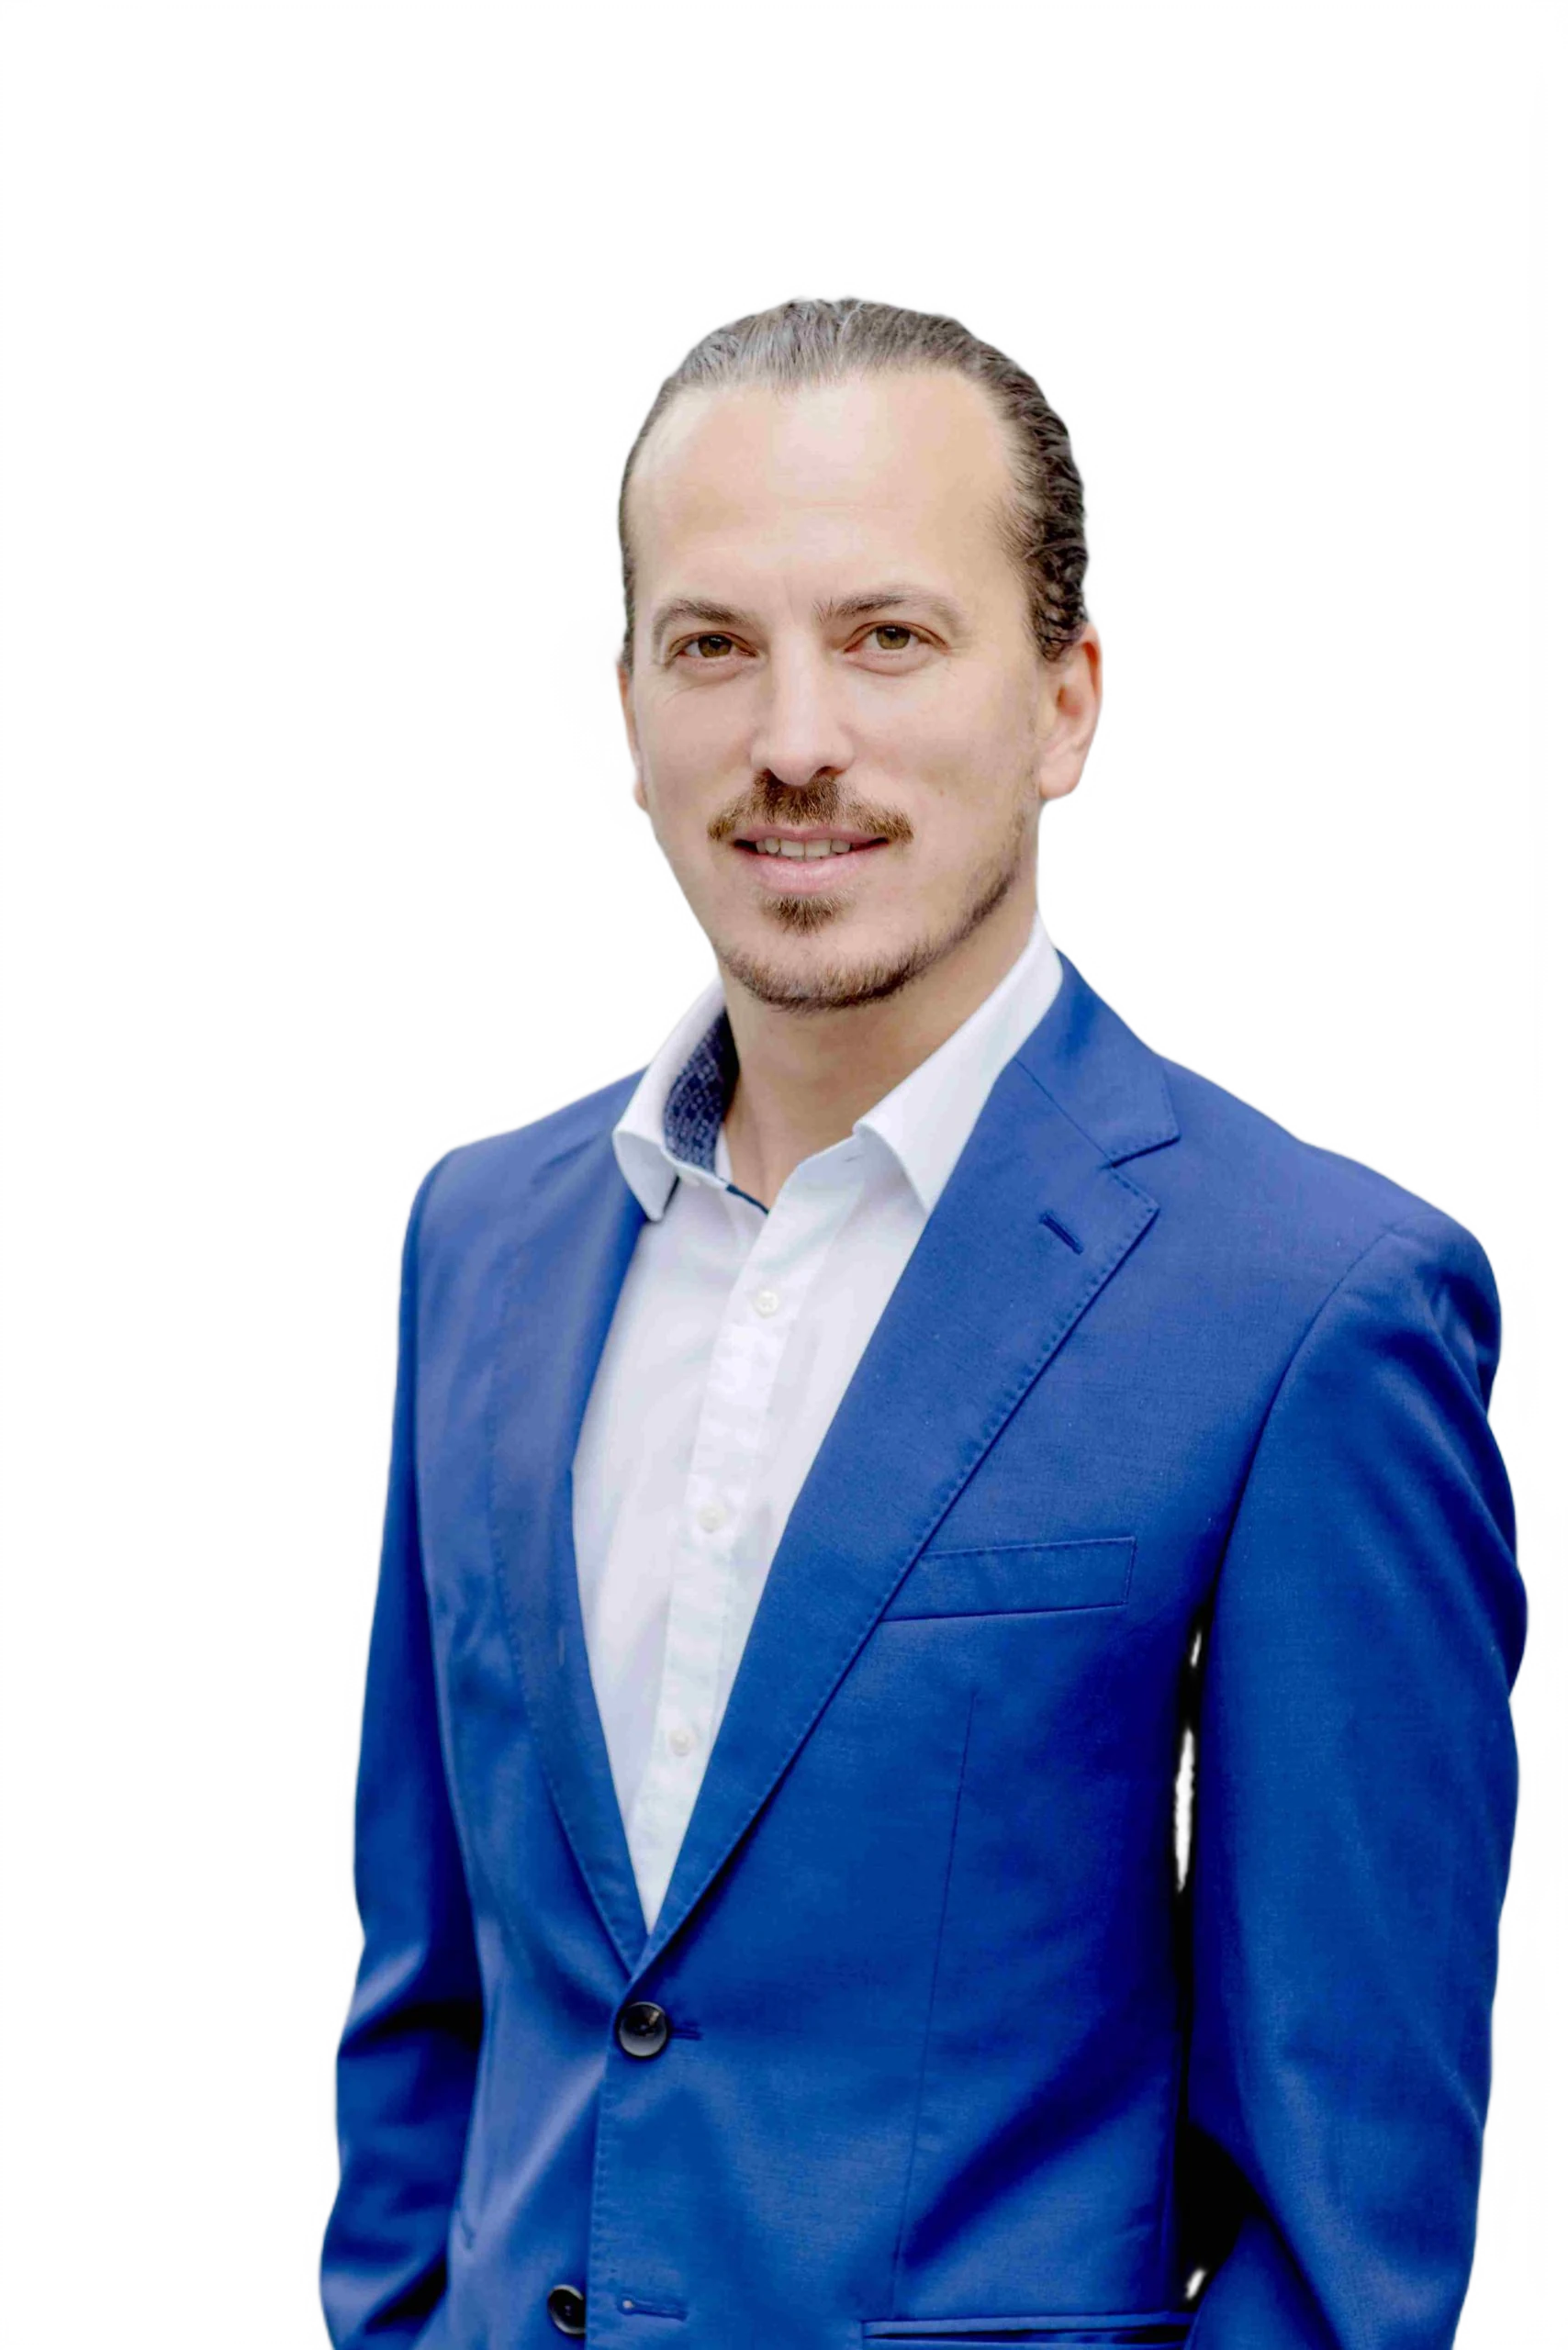
Jonas Lünendonk
 YouTube
 Spotify
Jeder von uns bekommt eigentlich den weltsmartesten Praktikanten an die Hand.
Die ganze Folge mit Jonas
Erst mit deinem Klick wird eine Verbindung zu YouTube aufgebaut und deine IP-Adresse übermittelt. Wir verwenden den erweiterten Datenschutzmodus von youtube-nocookie.com.
7 Dinge, die du aus der Folge mitnimmst
- 01
Lerne die KI-Basics, so selbstverständlich wie Excel
Ohne breite KI-Grundkenntnisse bis 2030 sieht Jonas ein massives Problem. Wissen dazu gibt es kostenlos im Netz, du brauchst nur Motivation und Zeit.
- 02
Behandle KI wie einen sehr smarten Praktikanten
Die Ergebnisse eines Praktikanten würdest du nicht ungeprüft an Kunden weitergeben. Genauso solltest du KI-Antworten immer fachlich beurteilen können.
- 03
Gib der KI Kontext, bevor du fragst
Wer nur fragt, was er der Oma schenken soll, bekommt Rückfragen. Sag der KI, wer du bist und worum es geht, dann reagiert sie richtig.
- 04
Beschreibe genau, welches Ergebnis du willst
Überleg vorher, ob du eine Liste, eine Tabelle oder 15 Folien mit Headline willst. Gerade diese Steuerung des Outputs hält Jonas für sehr wichtig.
- 05
Setz auf Austausch statt auf einen Prompting-Kurs
Zwei Stunden Schulung reichen nicht, Mitarbeiter müssen selbst Erfahrungen sammeln. Communities, in denen sie Dinge teilen und voneinander lernen, bringen KI wirklich ins Unternehmen.
- 06
Starte mit standardisierbaren, häufigen Prozessen
Frag dich, wie oft ein Prozess vorkommt, ob er sich standardisieren lässt und ob die Daten da sind. Erst standardisieren, dann digitalisieren, dann automatisieren.
- 07
Nutze die KI-Funktionen deiner bestehenden Software
Schau nicht nur auf Chat-Oberflächen, sondern auf KI-Features in Salesforce, HubSpot, SAP oder Personio. Dann bleiben Mitarbeiter in ihrer gewohnten Umgebung.
Jonas Lünendonk
Jonas Lünendonk entwickelt KI-Strategien für B2B-Dienstleistungsunternehmen. Er versteht sich als Brücke zwischen Data Science und Business und erarbeitet mit Unternehmen eine klare Roadmap, Schritt für Schritt, auf dem Weg zum KI-gestützten Unternehmen. Dazu gehören Schulungen, Guidelines und die Entwicklung von Use Cases.
Für die Umsetzung bringt er technische Partner zusammen, etwa für SharePoint oder Azure, und behält dabei Datenschutz und ethische Fragen im Blick. Bevor er sich der KI widmete, war er Marktforscher und hat viele Studien geschrieben. Heute hält er außerdem regelmäßig Vorträge über KI in der Arbeitswelt.
Fragen, die Jonas in der Folge beantwortet
Jonas beschreibt KI im weitesten Sinne als Statistik: Die Modelle arbeiten mit Wahrscheinlichkeiten und erzeugen auf Basis gelernter Muster Texte, Bilder, Videos oder Audio. Geforscht wird daran seit 60 bis 70 Jahren. Neu ist, dass man solche hochentwickelten Algorithmen jetzt mit natürlicher Sprache nutzen kann, ganz ohne Data-Science-Hintergrund.
Für Jonas ist KI eine General Purpose Technology wie Dampfmaschine oder Strom, diesmal für den Dienstleistungssektor. Dort machen Personalkosten meist 50 bis 70 Prozent aus, und KI senkt die Kosten des Denkens dramatisch.
Statt jeden Arbeitsschritt selbst zu erledigen, beschreibt man künftig das gewünschte Ergebnis. Fachleute werden stärker zu Prüfern, die Ergebnisse beurteilen und verbessern.
Der EU AI Act legt fest, wie Algorithmen nach Risikoklassen eingestuft werden, wen das betrifft und welche Maßnahmen Unternehmen je nach Kategorie treffen müssen. Dazu gehört auch, dass Mitarbeiter im Umgang mit KI geschult sein sollen. Jonas findet die Einteilung in Risikoklassen gut, kritisiert aber den bürokratischen Aufwand und die Dokumentationspflichten, die vor allem KI-Startups bremsen.
Jonas empfiehlt, auf diese Punkte zu schauen:
- Lässt sich der Prozess standardisieren und kommt er häufig vor?
- Sind die nötigen Daten vorhanden?
- Ist der KI-Einsatz regulatorisch und ethisch in Ordnung?
- Gibt es im Unternehmen die IT-Kompetenz, um die Lösung zu betreiben?
Außerdem lohnt der Blick auf KI-Funktionen, die schon in vorhandener Standardsoftware stecken.
Je spezieller das Wissen, desto eher erfindet ein Sprachmodell eine Antwort, die gut klingt, aber inhaltlich nicht stimmt. Auch bei der Websuche funktionieren Links oder Zusammenfassungen nicht immer. Jonas rät, immer das Fachwissen zu haben, um eine Antwort zu beurteilen, und Antworten im Unternehmenswissen zu verankern.
Agenten funktionieren laut Jonas heute vor allem in geschlossenen Systemen wie Salesforce oder ServiceNow, wo Prozesse branchenübergreifend ähnlich sind. Wer eigene Agenten bauen will, braucht standardisierbare Prozesse, gute Daten und das Wissen, solche Lösungen zu entwickeln und zu betreiben. Viele wollen Agenten, bevor sie überhaupt prompten können oder ihre Daten vorbereitet haben.
Ein zweistündiger Prompting-Kurs reicht nach Jonas' Erfahrung nicht. Mitarbeiter brauchen Zugang zu einem Sprachmodell in einer sicheren, konformen Umgebung, Zeit zum Ausprobieren und Communities, in denen sie voneinander lernen.
Ein guter Einstieg ist, dass jeder seinen eigenen persönlichen Assistenten baut. So verstehen die Leute, was ein Prompt ist und wie ein Assistent funktioniert.
Das ganze Gespräch zum Nachlesen
0:00Intro
In diesem Podcast spreche ich mit Jonas Lünendonk über KI und vor allem auch darüber, wie KI unsere Volkswirtschaft beeinflussen wird. Ich bin der Meinung und Jonas auch: Ob wir es wahrhaben wollen oder nicht, KI wird uns einfach massiv beeinflussen. Und du hast halt die Wahl, KI zu nutzen oder es halt nicht zu nutzen. Und die Leute, die es nicht nutzen werden, werden irgendwo den Anschluss verlieren und nicht mit den Leuten mithalten können, die halt KI als Werkzeug in ihrem Leben einsetzen.
Jonas und auch ich sind irgendwo der Meinung, dass jeder KI ein Stück weit auf jeden Fall lernen sollte. Jeder sollte zumindest die Basics beherrschen. Das bedeutet, dass man versteht, was ein Kontext ist, wie man eine KI ordentlich promptet, wie man sie für verschiedene Szenarien einsetzt etc. etc.
Außerdem haben wir im Podcast darüber gesprochen, wie KI die Kosten in Dienstleistungsunternehmen dramatisch senken wird und dadurch natürlich auch weniger Leute gebraucht werden oder eher andere Leute gebraucht werden. Und wie man auch seine Mitarbeiter mit KI am besten in Berührung bringt: dass halt eben verschiedene Experimente gemacht werden, ein Austausch herrscht zum Thema KI und dass man so auch im Unternehmen eine gewisse Wissensgrundlage für KI erschafft. Und dass man halt eben nicht nur einen kurzen Prompting-Kurs macht und sich danach nie wieder mit dem Thema KI wirklich beschäftigt, sondern dass man wirklich immer wieder aktiv im Austausch ist und voneinander lernt.
Jonas Lünendonk ist Berater für KI-Strategien für B2B-Dienstleistungsunternehmen. Er hilft im Endeffekt Unternehmen, eine KI-Strategie zu entwickeln, und wie man auch wirklich KI dann im Unternehmen einsetzen kann: was man dafür braucht, wie man das Ganze aufsetzt, worüber man nachdenken sollte, welche ethischen Probleme eventuell entstehen könnten, wie man diese löst, welche Datenschutzprobleme entstehen können, wie man diese löst und so weiter und so fort. Das sind alles Themen, mit denen sich Jonas durchgehend beschäftigt, und ich bin mir ganz sicher, du wirst in diesem Podcast von seinem Wissen profitieren. Ich wünsche dir ganz viel Spaß beim Zuhören.
1:49Was KI eigentlich ist und warum sie jetzt boomt
Es kommt einem ja ganz generell wie so eine sehr einfache Frage vor und man hat das Gefühl: Hey, eigentlich müsste man sowas wissen, also eigentlich weiß es doch jeder. Aber ich glaube, viele verstehen trotzdem noch nicht in der Tiefe, was KI wirklich ist. Von daher auch meine, in Anführungsstrichen, einfache Frage an dich: Was ist KI eigentlich und was bedeutet KI für unsere Volkswirtschaft, Stand jetzt?
Ja, ich fange mal vorne mit KI an. Was ist KI? Ich glaube, KI gibt's ja schon ganz lange. Wie lange forschen wir da schon dran? 60, 70 Jahre. Und ich glaube, diese Zugänglichkeit hat einfach jetzt durch ChatGPT stattgefunden, sodass es in der breiten Masse angekommen ist.
Weil wenn man sich die letzten, sag mal, die 2010er Jahre ansieht, dann haben wir da halt ganz viel analytische KI gemacht, eben Clustering, Forecasting, Time Series Prediction und sowas. Aber das waren halt immer Tools, da musstest du irgendwie einen Data-Science-Background schon haben oder ein bisschen Statistik einfach können, und dann konntest du irgendwie mit Power BI, Python, R und so weiter diese Algorithmen nutzen.
Ich glaube, das Spannende jetzt ist einfach bei Generative AI diese Zugänglichkeit, solche hochentwickelten Algorithmen einfach mit natürlicher Sprache zu nutzen. Das ist eigentlich der Gamechanger und deswegen haben wir, glaube ich, so eine hohe Adaptionsrate plötzlich.
Und ja, Generative AI, oder sagen wir AI oder insbesondere Generative AI, ist natürlich im weitesten Sinne einfach auch Statistik. Also das muss man einfach wissen, dass wir es da halt mit wahrscheinlichkeitsbasierten Modellen zu tun haben, die gut sind, die auch häufig gute Antworten liefern. Aber wir sollten trotzdem manchmal ein bisschen vorsichtig sein, ob wir alle Ergebnisse, die da kommen, eben eins zu eins übernehmen oder ob wir sie einfach noch mal prüfen. Das ist wichtig irgendwie zu KI.
Ich hab KI auch selbst das erste Mal mitbekommen, tatsächlich irgendwie, als ich 14, 15 war. Also das ist jetzt auch schon gut 12, 13 Jahre her. Da habe ich das erste Mal gesehen, wie sie ein Spiel gespielt hat, nämlich Super Mario World, falls du es kennst. Da gab es einen Programmierer, der hat eine KI dazu gebracht zu lernen, welche Dinge man tun muss, um halt eben so eine ganze Stage in Super Mario World durchzuspielen.
Das war das erste Mal, dass ich das gesehen habe. Und der hat dann auch irgendwie grafisch dargestellt, wie die KI dann tatsächlich gelernt hat, also welche Verknüpfungen im Gehirn quasi stattgefunden haben, damit sie dann versteht: Okay, ich muss jetzt hier springen, ich muss jetzt hier weiterlaufen etc. Das war also das erste Mal, wo ich das selbst mal mitbekommen habe.
Ich glaube, gerade Spieleumgebungen sind natürlich ein tolles Feld, weil wir da eine klar definierte Umwelt mit klar definierten Regeln haben. Da gibt's irgendwie ein Schachbrett, oder AlphaGo oder andere. Und dann kann ich natürlich auf gewissen Zügen, die schon da waren, trainieren. Und dann kann ich, ich sage jetzt mal, so als Brute-Force-Ansatz, natürlich das System gegen ein anderes KI-System spielen lassen, und es verbessert sich natürlich dann immer weiter, verbessern, verbessern.
Ich würde sagen, in der realen Welt ist es manchmal noch ein bisschen schwierig, weil wir da nicht diese abgeschlossene Umwelt haben. Aber nichtsdestotrotz, ich glaube, wir kommen immer weiter in diese Richtung, dass die Systeme immer mehr Variablen mitverarbeiten können.
Also so viel ich auch gerade eben von deiner Erklärung verstanden habe, basiert KI im Endeffekt irgendwo auch auf Statistik und basiert darauf auch ihre Antworten. Ist das jetzt, sage ich mal, die einfache Erklärung von KI oder wie würdest du KI vielleicht noch einfacher erklären?
Wie würde ich KI noch einfacher erklären? Ja, das ist eine gute Frage. Ich glaube, es kommt wirklich drauf an, weil wir halt so verschiedene Ausprägungen davon haben. Es gibt halt, wie gesagt, nicht die KI, es gibt halt verschiedene algorithmische Lösungen im Sinne von analytischer oder generativer KI.
Und die einen können basierend auf den gelernten Mustern halt eben dann Bilder, Texte, Videos, Audiodateien und anderes erzeugen. Sind sie immer perfekt? Nein, aber man kann schon sehr, sehr gut reproduzieren, sage ich mal.
Verstanden.
6:01KI als Dampfmaschine der Dienstleistung
Was bedeutet KI für unsere Volkswirtschaft? Wird es irgendwie alles umschmeißen? Wird alles weiterlaufen, wie es ist? Was denkst du?
Ja, ich glaube, KI ist, vielleicht denkt man manchmal, das ist zu hochgegriffen, aber ich glaube es nicht, wie die Dampfmaschine, Strom oder der Verbrennungsmotor. Ich glaube, es ist diese General Purpose Technology, die alles verändern wird. Und ich glaube, das Interessante ist einfach, dass wir in den letzten 200 Jahren die physische Arbeit, die Muskelkraft, automatisiert haben, eben mit diesen Maschinen.
Und was sind wir denn heute? Wir sind heute zu einer Dienstleistungsgesellschaft geworden, sagen wir. Also wir sind nicht mehr im primären und sekundären Sektor unterwegs, sondern maßgeblich im tertiären Sektor, im Dienstleistungssektor. Und ich glaube, dass KI schon die Dampfmaschine jetzt wirklich für den tertiären Sektor ist.
Weil wenn wir daran denken, was macht so eine General Purpose Technology aus: Sie hat sehr, sehr viele Anwendungsfälle, wir können sie in vielen Industrien oder vielen Dienstleistungssektoren einsetzen und für viele verschiedene Aufgaben. Und wenn wir mal überlegen, ich kann es einsetzen in Finanzen, in Handel, in Marketing, in Sales, also wir können die ganze Porter Value Chain eigentlich durchgehen. Und wenn wir da an einem Whiteboard stehen würden, dann würde uns wahrscheinlich an jeder Ecke irgendwie was einfallen.
Das heißt, die Möglichkeiten, Generative AI oder künstliche Intelligenz im Dienstleistungssektor einzusetzen, die sind auf jeden Fall gegeben. Und was ist denn üblicherweise die größte Herausforderung von einem Dienstleistungsunternehmen? Das sind die Personalkosten. Normalerweise hast du in einem Dienstleistungsunternehmen zwischen 50 und 70 % Personalkosten. Und ich glaube, das, was KI macht: Das reduziert eben dramatisch die Kosten des Denkens.
Also sagen wir mal, man muss Market Research machen, wir müssen irgendwelche Artikel schreiben, wir müssen vielleicht irgendwelche Marketing-Assets produzieren. Das kann ich eben jetzt dann zukünftig mit generativer KI deutlich schneller machen, deutlich günstiger machen. Und ich glaube, das ist der erste Teil, der sich schon mal verändert.
Und ich glaube, was ganz maßgeblich auch ist, ist, dass wir von einer Arbeit weggehen, die da heißt, wir arbeiten imperativ. Ich mach's mal an einem einfachen, transparenten Beispiel: Blogartikel schreiben. Ich habe vielleicht zwei Begriffe, KI, Professional Services, dazu will ich irgendwie was schreiben, was da die Chancen sind. Dann würde ich erstmal einen Research machen, geh ins Internet, stell mir auf Basis meines Research dann vielleicht eine Gliederung auf, dann schreibe ich diesen Artikel.
Ich habe eine gewisse Vorstellung davon, wie lang der sein soll, vielleicht irgendwie, sag mal, 5.000 Zeichen, so und so viele Absätze. Dann schreibe ich den, dann gebe ich den ins Lektorat, der liest den vielleicht noch mal durch, dann erstelle ich vielleicht noch eine Grafik dazu und dann habe ich das fertige Ergebnis. Das heißt, ich muss das Ganze eigentlich Schritt für Schritt durcharbeiten.
Was jetzt eigentlich mit generativer KI passiert, ist: Wir können diese ganzen Schritte mit natürlicher Sprache in Software inkorporieren. Und dann muss ich nur noch beschreiben, was ich will, im Sinne von: Ich brauche einen Blogartikel über KI und Professional Services, der sich an einen Geschäftsführer richtet, der soll so lang sein und der soll irgendwie noch Stichpunkte drin haben. Und dann werden alle diese Schritte im Hintergrund durchgeführt.
Das heißt, das wird in ganz vielen Dienstleistungsunternehmen so sein, dass gerade dieses Prozesswissen gar nicht mehr so entscheidend sein wird, sondern eher die Art und Weise, wie ich mit der Maschine kommunizieren kann, was ich eigentlich genau will. Was soll denn das genaue Endergebnis sein?
Das Gleiche haben wir z. B., stellen wir uns einen Junior-Logodesigner von früher vor, einen Grafikdesigner: Der musste erstmal grafische Prinzipien lernen. Dann ist er vielleicht in ein Unternehmen reingekommen, dann hat er noch InDesign gelernt, und dann ist er mit zum Kunden gegangen, hat irgendwie auch noch ein bisschen was gelernt. Und dann irgendwann hieß es, na gut, er soll jetzt irgendwie ein Logo designen, und dann wusste er irgendwie, Managementberatung, das muss irgendwie blau oder grün sein, sage ich jetzt mal, so ein bisschen verkürzt.
Aber das brauche ich ja eigentlich so nicht mehr. Diese ganzen einzelnen Schritte brauche ich nicht mehr. Ich brauche nur noch zu sagen: Ich brauche ein Logo für eine Managementberatung, die ist in dem und dem Umfeld, die ist spezialisiert auf eins, zwei, drei, vier. Und dann kriege ich entsprechende Vorschläge.
Jetzt wird der eine oder andere sehr gute Grafikdesigner oder Blogartikelschreiber oder Ähnliches sagen: „Na ja, ich mache das aber besser.“ Absolut. Das ist auch so. Nur das Entscheidende ist, dass ich innerhalb von, ich sage jetzt mal, 20 Sekunden ein Ergebnis bekomme, das wahrscheinlich schon zu 80, 90 % gut ist, und darauf kann ich dann iterieren.
Und das ist eben diese Geschwindigkeit, die plötzlich reinkommt, dass ich eben ein Basisergebnis innerhalb von Sekunden, Minuten vielleicht schon habe, ohne dass ich dafür jetzt jemanden brauche, der irgendwie gerade von der Hochschule kommt und das dann eben macht. Aber das führt natürlich dazu, dass alle Leute, die sehr, sehr gut in ihrem Feld sind, sehr, sehr gut ausgebildet sind, natürlich dann in eine Rolle gedrängt werden, die da heißt: Da wird sehr, sehr viel generiert, aber du bist eigentlich der Judge.
Du musst immer drauf gucken und das Ganze noch mal beurteilen, im Sinne von: Wie gut ist das denn? Und dann darauf eben weiter iterieren. Und ich glaube, es wird eine maßgebliche Veränderung für unsere Dienstleistungsgesellschaft sein. Nicht jetzt vielleicht für die körpernahen Dienstleistungen, aber für alle, die eben White-Collar-Jobs haben, ob das eben Programmierer, Marketingspezialisten, Audio, Video und so weiter sind. Also, es wird in allen Bereichen irgendwo seine Anwendung finden.
11:28Was passiert mit Arbeit und Einkommen?
Wie sieht diese Veränderung ganz konkret im Alltag dann aus, oder halt einfach im Volk insgesamt, sage ich mal? Die haben ja dann, einfach mal grob gesagt, weniger Arbeit. Was passiert dann mit den Menschen etc.?
Ich würde sagen, das wissen wir noch nicht so genau. Also ich glaube, eine der ersten Fragen, die meistens kommt, ist: Na ja, wie ist denn das eigentlich, wenn du das Ganze nicht mehr von der Pike auf gelernt hast? Bist du dann überhaupt in der Lage, von KI generierte Ergebnisse wirklich zu hinterfragen?
Also ich sage jetzt mal als vereinfachtes Beispiel: Wir haben vielleicht noch gelernt, mit einer Karte Auto zu fahren, und dann wussten wir, die Straße ist in H3, und dann haben wir uns auf der Karte da zurechtgefunden. Dann haben wir auch ein bisschen Navigationsfähigkeiten einfach gewonnen oder während unseres Lebens dazugelernt. Heute ist es halt so, wenn ich dann vielleicht Google Maps verwende, achte ich vielleicht auf solche Dinge gar nicht mehr. Ich geb Frankfurt ein und fahre dann plötzlich nach Frankfurt an der Oder und nicht nach Frankfurt am Main und merke aber eigentlich gar nicht, dass ich himmelsrichtungsmäßig eigentlich nicht in die Richtung fahre.
Oder ich sage jetzt mal klassisch: Du importierst irgendwie eine CSV-Datei, so eine Excel-Datei, und plötzlich schneidet der bei Postleitzahlen irgendwie die führende Null ab. Und dann sagt er dir plötzlich: „Na ja, also ein paar von deinen Kunden sind in Österreich“, weil es vierstellige Postleitzahlen sind. Da muss ich natürlich sofort sehen: Ach stimmt, der schneidet mir die Null ab, da muss ich noch mal drauf gucken. Sowas kann natürlich schon passieren, wenn wir eben ungeprüft diese KI-Ergebnisse übernehmen.
Aber wie ich mir eigentlich KI vorstelle, ist: Jeder von uns bekommt eigentlich den weltsmartesten Praktikanten an die Hand, neben sich gesetzt. Jeder von uns hat jetzt eigentlich einen sehr, sehr smarten, intelligenten Praktikanten, der einen halt in ganz vielen Aufgaben unterstützen kann. Würde ich diese Ergebnisse meines Praktikanten ungeprüft an Kunden, an Kollegen weitergeben? Nein, aber es ist natürlich eine enorme Hilfe.
Jetzt ist die Frage, was passiert vielleicht zukünftig mit den Menschen, wie machen wir das? Ich glaube, die Frage ist noch nicht gelöst. Die traue ich mir jetzt auch nicht zu zu beantworten. Aber was ich schon sehe, ist: Wie kann ich denn heute Einkommen erzielen? Ganz klassisch, also aus der Volkswirtschaft: Boden, Arbeit, Kapital.
Boden sind halt Häuser und Grundstücke, Kapital sind Investments in Firmen, und dann habe ich eben meine Arbeitskraft. Und ich glaube, die Herausforderung ist schon, dass Arbeitskraft halt zunehmend unter Druck kommt, und dann kann ich halt eher Einkommen erzielen über Boden oder eben über Kapital. Also wenn mir halt die Rechenzentren gehören, die Infrastruktur, die Algorithmen, eine Software-Solution, die eben so etwas tut, die eben einen Dienstleistungsprozess als Service liefert. Und wenn ich aber wirklich nur meine Arbeitskraft anzubieten habe, dann, glaube ich, wird es schwer.
Und was ich vielleicht auch ein bisschen feststelle gerade, ist dieser Punkt: „Na ja, KI, und ich habe eigentlich nicht so viel Zeit, ich kann mich echt damit gar nicht auseinandersetzen, ich habe nicht so viel Zeit.“ Ich glaube, wenn wir keine Basis-KI-Fähigkeiten in der Breite der Bevölkerung haben bis 2030, werden wir ein massives Problem haben. Weil das sind Fähigkeiten wie PowerPoint, wie Excel, wie das Interagieren mit einem PC. Und das müssen wir, glaube ich, schon können und verstehen.
Und vielleicht als kleine Gedankenidee dazu: Ich glaube, sehr, sehr viele von uns könnten, wenn ich fragen würde, wie funktioniert eine Dampfmaschine, das einigermaßen erklären. Wenn ich fragen würde, wie funktioniert ein Verbrennungsmotor, weiß man wahrscheinlich auch irgendwie so, Benzin und Zylinder und sowas, ne? Und Kupplung. Und gleich ist es irgendwie auch bei Strom.
Und ich glaube aber, dass wir dieses Basisverständnis schon in der Bevölkerung brauchen, was KI kann, was sie nicht kann, wie sie funktioniert, damit wir da nicht so völlig ahnungslos sind. Also ich glaube, in China oder anderen Ländern ist die, wie sage ich, Ausbildung im Hinblick auf Basisverständnis von KI schon deutlich weiter als beispielsweise jetzt bei uns.
Ja, ich habe gerade heute einen Post gelesen auf LinkedIn, dass man in China beigebracht bekommt, wie man halt eben KI promptet, direkt irgendwie in der vierten Klasse oder so, also dass man dann direkt schon damit aufwächst quasi. Und mit Deutschland hatte jemand halt den Post verglichen, dass Unternehmer sich gerade mal ChatGPT angucken hier in Deutschland. Und es ist schon sehr verrückt.
Und ich finde auch, wer diese KI-Kenntnisse irgendwie komplett an sich vorbeiziehen lässt in den nächsten Jahren, wird einfach irgendwo hinten anstehen. Das ist einfach ein Teil von der Welt, den man nicht mehr wegdenken kann. Also es wird einfach in diese Richtung gehen, ob man es jetzt haben möchte oder halt nicht, denke ich.
Genau. Ja. Und ich sage es mal auch vor dem Hintergrund: Das Wissen ist ja heute sehr, sehr zugänglich. Also auf Coursera, von Microsoft, auf YouTube, überall gibt es eigentlich Quellen, wo ich mir die Basics schon aneignen kann. Also es ist jetzt ja nicht mehr so, dass es irgendwie verstecktes Wissen ist, dass ich irgendwie eine teure Weiterbildung besuchen muss, um überhaupt irgendwie was zu verstehen.
Sondern ganz, ganz viel Wissen ist da kostenfrei draußen im Internet. Man muss halt aber die Motivation haben, das auch zu lernen und die Zeit zu investieren.
Auf jeden Fall.
17:04Deutschland im Rennen mit den USA und China
Apropos China: Wo stehen wir in Deutschland mit dem Thema KI versus Amerika, China, Russland etc.?
Ja, jetzt bin ich kein China- oder Russland-Experte. Ich glaube aber, so wie wir es gerade sehen, was im Sinne von Startups da kommt, was an Large Language Models veröffentlicht wird, sind Amerika und China natürlich schon die zwei Dominanten in dem Spiel. Ich finde es interessant, dass die Chinesen so stark Open Source unterwegs sind und die Amerikaner eher auf die geschlossenen Systeme setzen, im Sinne von: Die Gewichte der Modelle sind halt nicht offen.
Und dann siehst du plötzlich ein Modell irgendwie von Alibaba, ich glaube Qwen 3, das dann eben eine Performance hat so gut wie Google Gemini 2.5, aber halt ein Open-Source-Modell ist. Und da gibt es natürlich dann schon die Überlegung: Kann es nicht dazu führen, dass sich eigentlich weltweit, sag ich mal, chinesische Open-Source-Modelle vielleicht auch in Drittstaaten verbreiten und die westliche Welt, ich sag jetzt mal USA, Europa, halt dann auf ihren proprietären Modellen sitzen bleibt? Also, da müssen wir mal gucken.
Ich glaube, in den USA wird natürlich massiv investiert, genauso wie in China. Ich glaube, in Europa sind wir halt einfach ein kleinerer, fragmentierter Markt. Wir haben natürlich auch das Thema Datenschutz, da sind wir, glaube ich, kritischer, auch beim Thema Urheberrechte. Aber die Frage ist natürlich, wenn der CEO von Perplexity sagt: „Na ja, everybody copies everybody.“ Das war, glaube ich, gerade der Moment, als DeepSeek rausgekommen ist. Da ist natürlich dann schon die Frage: Sind wir dann irgendwann am Ende die Doofen, wenn wir das Ganze halt zu regulatorisch machen?
Gut, auf der anderen Seite, ich sag jetzt mal, ich habe gerade auch einen Bericht über die Schweiz gelesen. Da wurde gerade ein Open-Source-Modell für die Schweiz, für die Verwaltung irgendwo entwickelt, das sehr, sehr gut läuft. Also ich glaube, von der Forschungsseite her, ob das jetzt hier z. B. in München die TUM ist oder auch in Heidelberg, da gibt's ja einen Cluster, der recht groß ist, oder auch das Hasso-Plattner-Institut und andere, sind wir schon gut aufgestellt.
Wir tun uns halt oft schwer, das dann wirklich in ein skalierendes, großes Geschäftsmodell mit dem entsprechenden Netzwerkeffekt zu transformieren.
19:21Urheberrecht und der Streit um Trainingsdaten
Was ich auch vor Kurzem in den Nachrichten gesehen hatte, ich glaube, es war sogar von China: dass sie auch wirklich gesagt haben, dass sie so ein internationales Regelwerk für KI einführen wollen. Was denkst du da so drüber?
Wer möchte das einführen?
China, glaube ich.
Ja. Wir haben ja verschiedene Regelwerke mittlerweile schon von verschiedenen Ländern. Kommt immer, glaube ich, so ein bisschen darauf an, wo die dann einen Schwerpunkt darauf legen.
Also, ich sage jetzt mal, ich persönlich z.B.: Ich bin früher Marktforscher gewesen und habe natürlich auch viele Studien geschrieben, und da ist viel Arbeit reingeflossen. Und wenn ich jetzt natürlich sehe, dass diese Intellectual Property einfach aufkonsumiert wird von den Large Language Models und dann wiedergegeben wird, ist das natürlich schon schwierig, ja?
Oder wenn z.B. Meta sagt, na ja, auch wenn wir Bücher finden, z.B. in der russischen Datenbank, auch wenn wir wissen, dass die eigentlich urheberrechtlich geschützt sind, dann nehmen wir die trotzdem fürs Training her. Oder wir kaufen Secondhand-Bücher à la Anthropic, machen den Einband weg und scannen dann einfach das komplette Buch ein, und das ist dann dort reintrainiertes Wissen. Na ja, das ist schon die Frage, ne?
Wenn du z.B. halt eben Künstler bist und hast einen gewissen Stil, und dann plötzlich würden deine Bilder da fürs Training verwendet. Und dann sagst du: „Ich möchte gerne mal hier in dem Stil von Jonas das Bild haben“, und dann kommt dieses Bild plötzlich im Stil raus. Dann ist natürlich schon die Frage: Ist es nicht eigentlich meine Intellectual Property? Ja.
Aber ich sag es mal, in Amerika läuft das halt eben oft unter dem Punkt Fair Use, dass man sagt: Okay, wir dürfen es nutzen, um unsere Modelle zu trainieren. Und da gab's gerade auch einen Brief ans Weiße Haus von einigen größeren Techunternehmen, die gesagt haben: Wenn wir dieses Thema Fair Use nicht haben und wir nicht auf diesen öffentlichen Daten trainieren dürfen, dann werden wir im Kampf gegenüber China zurückfallen.
Und jetzt wurde, glaube ich, gerade eine neue Guideline vom Weißen Haus im Sinne von AI Policy veröffentlicht. Und ich denke, das geht so ein bisschen in die Richtung, dass man eher mehr zulässt, um halt einfach technologisch vorne zu sein, und auf dieses Thema, soll ich sagen, Urheberrechte und so etwas nicht ganz so viel Wert zu legen.
Ich find es ehrlich gesagt auch spannend vor dem Hintergrund, weil ich kann mich noch erinnern: 2016, 2017 war mal so der Punkt „Data is the new Oil“. Und wenn du aber heute so guckst, z.B. ob Google oder ein Meta oder OpenAI, wenn du da mal reinguckst, für was geben die denn Geld aus? Na ja, maßgeblich für Rechenzentren, für Computer und für die Entwicklung von Algorithmen, aber für die Daten haben sie nicht so viel Geld ausgegeben.
Ja, deswegen ist dieser Move z.B. von Cloudflare, die sehr, sehr viele Websites schützen, auch interessant im Sinne von: Hey, blocken wir vielleicht zukünftig die Crawler von den großen KI-Firmen und sagen, du kannst die Website crawlen, aber dann musst du dafür Geld bezahlen. Also, es ist alles so ein bisschen im Fluss gerade, würde ich sagen.
Was ist deine persönliche Meinung zum Thema Urheberrecht?
Na ja, die Frage ist: Wie wird argumentiert? Es wird gesagt, wenn du jetzt z.B. zehn Bücher liest zu einem gewissen Thema und erstellst dann eben das elfte Buch, dann referenzierst du ja auch auf das Wissen quasi der anderen. Die Frage ist halt aber: Ist eine KI dann genauso zu beurteilen? Weil die kann ja innerhalb von, sagen wir mal, 20 Sekunden zehn Bücher lesen und dann was produzieren. Ist es dann das Gleiche, wie ein Mensch vorgehen würde? Ich sehe es nicht so.
Beim Thema Urheberrechte gab's einen Artikel in der FAZ, den finde ich, traf es schon ganz gut. Da hat man gesagt: der größte Diebstahl der Menschheitsgeschichte. Ja, weil dieses ganze Wissen einfach abgesaugt wurde und fürs Training verwendet wurde. Man kann sagen, ja, dieses Wissen ist dann quasi da nur reintrainiert und nicht eins zu eins.
Aber auf der anderen Seite sind natürlich die ganzen Kreatoren, also, sind wir mal ehrlich, was ist denn eigentlich unser Problem mit Generative AI? Also, wenn wir daran denken, ich glaube, alle Kreatoren kommen unter Druck. Ob das der Sprecher für ein Hörbuch ist, ja, Synchronisierung, gerade gestern mit jemandem dazu gesprochen, ob das Video ist, ob das Bilder sind, ob das Texte sind, ob das Codes sind: All diese Informationen, die da reintrainiert wurden, die beruhen ja auf irgendjemandem, der das erstellt hat.
Ja, und diese Leute werden natürlich jetzt schon irgendwo durch KI digitalisiert. Weil jetzt ist es ein bisschen da drin, und jetzt kann ich sagen: Okay, jetzt produziere mir diesen Code, produziere mir dieses Bild mit diesem Baum. Na ja, okay, gut. Also, das ist schon eine Herausforderung, aber sind wir mal ehrlich. Ich hatte neulich, in der ARD war ein kurzer Bericht eben über, ich glaub, Synchronsprecher waren es, die dann eben so eine Petition irgendwie gelauncht haben.
Habe ich auch gesehen.
Ja, ich würde sagen: The genie is out of the bottle. Das Thema ist durch, es ist vorbei. Ja, also wir können nur noch, glaube ich, nach vorne adaptieren.
Und vielleicht, wenn es jetzt um das Thema Daten geht: Was mich schon manchmal irritiert in Deutschland, ist, dass wir auf der einen Seite diesen Datenschutz haben und sagen: „Hey, wenn du mir jetzt einen Newsletter schickst, wo ich nicht den Double-Opt-in gemacht habe, dann quasi Brief vom Anwalt.“ Aber auf der anderen Seite nutzen jetzt alle ChatGPT und besprechen da persönliche Probleme, laden da RFPs, Requests for Proposals, von Firmen hoch, laden da Verträge hoch, laden Unternehmenswissen, persönliche Daten, es wird alles hochgeladen.
Ja, und da frage ich mich dann schon, ob wir so ein bisschen eine Datenschutzschizophrenie haben in Deutschland. Und auf der anderen Seite, glaube ich, sitzen die großen Anbieter von den Large Language Models natürlich da und sagen: Wunderbar, diese ganzen Daten, die wir vorher nicht scrapen konnten, jetzt liefern uns die Kunden das also frei Haus.
Und ich glaube, das ist schon ein Punkt, wo man als Unternehmen auf jeden Fall drüber nachdenken muss: Kann ich meine Daten eben rüber in die USA transferieren, und vor allem irgendwie kostenfrei und ungeschützt, und Bring your own AI und so weiter? Das, glaube ich, ist auf Dauer nicht so gut.
Und vielleicht so ein kleiner Hinweis noch zu dem Thema Kinder. Ja, auch ganz viele Kinder nutzen eben Generative AI, weil wir ja jetzt in WhatsApp unten diesen Meta-Kringel, also Llama, eingebunden haben, oder eben auch ChatGPT. Und eine Harvard-Studie zeigt ja auch, dass einer der Use Cases ganz wesentlich ist, z.B. so Therapy and Companionship, wofür eben diese LLMs genutzt werden.
Das ist natürlich schon die Frage, wenn jetzt mit einer kostenfreien Version von ChatGPT ein Kind vielleicht Probleme bespricht, die es mit mir vielleicht nicht besprechen will, ich dann aber eben, sag mal, OpenAI fast schon ein Persönlichkeitsprofil liefere und wir wissen nicht genau, was die damit machen. Sind wir ganz ehrlich, beim Free Account wird sowieso gesagt: Wir werden das Modell für alle verbessern. Okay. Also da würde ich mich, glaube ich, schon zurückhalten, was das Thema persönliche Daten eingeben angeht.
Aber gut, auf der anderen Seite, wie gesagt, ich komme zurück zu der Datenschutzschizophrenie. Gerade vor ein paar Tagen hat mich Instagram wieder gefragt, ob ich jetzt 7,99 € bezahlen will, damit ich dann keine Werbung mehr erhalte. Ich habe da abgelehnt, weil, mein Gott, ich bin da eh schon drin, aber ist ja meine Entscheidung.
Aber wenn ich dann auf Veranstaltungen bin und manchmal eben so ins Publikum frage: „Wer von Ihnen bezahlt denn für Instagram, damit seine persönlichen Daten nicht genutzt werden?“, da geht keine Hand hoch. Und das ist eigentlich auch diese Limitation des Datenschutzes aus meiner Sicht. Große Techunternehmen haben einfach viele Ressourcen im Hinblick auf Anwälte, die natürlich ihre Datenschutzbestimmungen genau so schreiben können, dass wir genau diesen Haken noch da setzen und sowieso sagen: „We accept all.“
Aber als kleines mittelständisches Unternehmen habe ich eben nicht die Power, und dann tue ich mir halt schon schwer. Immer für meine spezifische Funktion, oder will ich wieder ein Feature implementieren, muss ich wieder gucken: Ah, passt es mit den Datenschutzbestimmungen? Und dann muss ich wieder zum Anwalt. Also es macht halt langsam, ne? Da haben wir einfach einen Nachteil.
27:49Datenschutz zwischen Sorgfalt und Stillstand
Was wären da praktische Lösungen, um den Datenschutz irgendwo vielleicht zu beachten, trotzdem aber auch voranzukommen?
Ja, das ist eine gute Frage. Ich weiß nicht, wie man das lösen kann. Es ist halt wirklich eine Balance zwischen, ich sage jetzt mal, Usability als Unternehmen, wie kann ich es einsetzen, und halt aber trotzdem irgendwie Security-Aspekten für meine Kunden.
Also ich meine, ich verstehe ja total, dass wir keine Bewerbungsdaten ganz lang speichern sollen, damit wir dann immer noch wissen: Ach, der Jonas hat sich mal vor 5 oder 10 Jahren da beworben, und da stand seine Bewerbung drin und so. Ja, oder auch medizinische Daten und so weiter, das verstehe ich alles. Aber wie man es pragmatisch und genau löst, ne? Weiß nicht, vielleicht gibt's da andere Länder, wo man mal hingucken kann, wo die es vielleicht so ein bisschen einfacher gemacht haben, aber es bremst uns, würde ich sagen, durchaus.
Also ein ganz klassisches Beispiel: Ich hatte gerade neulich mit einem Kunden ein KI-Tool implementiert, das auf europäischen Servern läuft, in den europäischen Clouds, keine Daten in die USA schickt. Und dann war das Gespräch mit dem Datenschutzbeauftragten, ne? Dann sagt er: „Ja, da dürfen ja keine persönlichen Daten rein.“ Sag ich: „Ja, gut, aber wenn ich mit KI E-Mails beantworte, Dokumente hochlade und so weiter, da sind persönliche Daten drin, die kann ich da nicht rauslassen.“
„Ja, gut. Aber wie ist es denn dann, wenn du jetzt, sage ich mal, mit dem Herrn Müller gechattet hast, mit dem Herrn Müller geschrieben hast, du hast seine E-Mail in diesem Tool beantwortet, dann ist der Name von dem Herrn Müller ja in dem Chatverlauf drin.“ Sag ich: „Ja.“ „Ja, aber wenn der jetzt die Datenschutzauskunftsanfrage stellt im Sinne von: Wo habt ihr meine Daten gespeichert? Dann müsste ich ja quasi transparent machen: Also im Chat von Jonas Lünendonk in dem Tool, da steht das drin.“
Und dann sagt der Datenschutzbeauftragte: „Ja, das müssen wir aber unbedingt machen.“ Sag ich: „Es geht nicht, das können wir nicht. Also ja, aber dann brauchen wir keine KI mehr, dann müssen wir alle Chats sofort löschen.“ Und das ist halt aber auch nicht im Sinne des Erfinders. Wir wollen es immer bis aufs Letzte halt durchexerzieren, und manchmal machen wir keine pragmatischen Lösungen, glaub ich.
Also irgendwo haben wir am Ende des Tages die Wahl zwischen: „Hey, wir finden eine Lösung“, oder: „Hey, wir versuchen, uns extrem datenschutzgerecht zu machen“, kommen dann aber nicht voran, oder? Wie siehst du das?
Ich glaube, wir sind halt manchmal zu genau und wollen es bis ins Kleinste ausdefinieren. Also, ich würde sagen, wenn wir jetzt schon ein datenschutzkonformes Tool ausgewählt haben und die Daten auf europäischen Servern sind und uns der Anbieter mit TOMs, technisch-organisatorischen Maßnahmen, und Auftragsdatenverarbeitungsvertrag und so weiter bestätigt, dass er diese Daten löschen kann, dann finde ich, sind wir da schon einen deutlichen Schritt weiter als jetzt Unternehmen, die einfach wild z.B. ChatGPT nutzen.
Aber dann kommt trotzdem noch der Datenschutzbeauftragte und sagt: „Ja, aber was ist denn in diesen Chats da?“ Okay, aber dann wird's schwierig. Also dann, ja, wir müssten, glaube ich, manchmal so ein bisschen pragmatischer sein.
Ja, mehr Flexibilität.
Ja. Ja, gut. Aber ich meine, die EU ist ja auch so ein Thema. Ich meine, wir haben jetzt die wenigsten Startups, glaube ich, gerade so im KI-Umfeld, haben aber schon halt eine relativ starke Regulierung jetzt erstellt.
Ich arbeite auch manchmal mit Personaldienstleistungsunternehmen zusammen. Traum ist natürlich: Du hast einen Personalbedarf, und dann habe ich da irgendwie CVs, und dann matche ich halt den Bedarf zu den CVs, und dann scort irgendwie die KI mir auf Basis eines Konzeptes, das ich mir überlegt habe, eben die Menschen. Aber das ist halt dann High Risk, ja, weil wir halt Menschen beurteilen.
Ja, das verstehe ich auch, dass wir dann eben sagen: Okay, wir müssen da vielleicht ein bisschen vorsichtiger sein, gerade wenn es um die Beurteilung beim Matchen geht. Da macht dann auch so ein EU AI Act Sinn, ne? Also ist schon okay. Aber manchmal machen wir das halt, glaube ich, ein bisschen zu kompliziert.
31:58Was der EU AI Act regelt und wo er bremst
Was hat's mit diesem EU AI Act auf sich?
Ja, gut, es regelt halt erst mal, wie Algorithmen zu klassifizieren sind, auch wen es betrifft, welche Anwender, welche Maßnahmen vielleicht auch Unternehmen treffen müssen, je nachdem, in welche Risikokategorie ihre KI-Lösung fällt, die sie benutzen. Und natürlich auch so Punkte rund um: dass die Mitarbeiter halt eben auch trainiert sein sollen, wenn die eben mit KI-Systemen interagieren. Und noch zwei, drei weitere Themen.
Ja, aber ich sag mal so, das Konzept an sich ist nicht schlecht, aber es hat einen gewissen bürokratischen Aufwand. Und es führt z.B. auch dazu, dass Unternehmen, die vielleicht z.B. in der Versicherungswirtschaft früher halt klassische Machine-Learning-Algorithmen genutzt haben, um halt Vorschläge zu machen oder Scores oder so was, dass die plötzlich auch eine Regelung haben und sagen: Oh, das fällt jetzt unter High Risk, jetzt müssen wir uns überlegen, müssen wir es jetzt abschalten, oder was machen wir jetzt eigentlich damit? Wie dokumentieren wir es jetzt? Wir haben halt enorme Dokumentationspflichten.
Verstehe. Was ist an diesem Act gut? Was weniger gut?
Also, ich finde grundsätzlich diese Kategorisierung in die verschiedenen Risikoklassen schon gut, auch mit den Maßnahmen, die dann eben dahinter zu treffen sind. Das ist ganz gut, aber es ist natürlich halt wieder ein extrem bürokratischer Akt, und wir haben noch nicht mal angefangen, es umzusetzen.
Also, ich glaube, wir sind manchmal da ein bisschen zu schnell mit der Regulierung und könnten es manchmal eher ein bisschen länger noch laufen lassen. Weil wir machen es natürlich auch KI-Startups schwierig, ja, weil die müssen sich natürlich dann durch den EU AI Act durchfräsen, die müssen sich durch den Datenschutz durchfräsen. Ja, und da geht halt enorm viel Geld und Ressourcen allein schon darauf, diese regulatorischen Anforderungen zu erfüllen, bevor ich überhaupt irgendwie ein Produkt auf die Schiene gebe.
Ja, und dadurch könnten wir auch eventuell wieder langsamer sein im Gegensatz zu anderen Ländern, Nationen etc.
Ja, genau.
33:54Ist die Angst vor KI berechtigt?
Gut, viele Leute, inklusive mir, machen sich auch irgendwo Gedanken oder haben vielleicht sogar Angst vor KI. Findest du es generell gerechtfertigt, dass Menschen Angst haben? Welche Ängste sind vielleicht realistisch und welche vielleicht eher ein Hirngespinst, deiner Meinung nach?
Ja, ob man sich Sorgen macht, das habe ich nicht zu beurteilen, sondern jeder hat so seine eigenen Sorgen. Ich glaube aber, was das Thema KI z.B. angeht: Ich weiß halt nicht, ob Angst da hilft, weil, ganz ehrlich, das Thema kommt sowieso, ob ich davor Angst habe oder nicht. Es wird kommen. Es scheint zumindest so, dass es so viele Benefits hat, dass diese Technologie sowieso kommen wird. Und deswegen bleibt mir eigentlich gar nichts anderes übrig, als mich damit auseinanderzusetzen, würde ich sagen.
Wird es viele Arbeitsplätze massiv verändern? Ja, absolut. Absolut. Und wenn wir früher gesagt haben, weiß nicht, wann war das, 2002 oder so, als ich noch in der Schule war, ne, da war so Agenda-2010-Zeit. Da hat man gesagt: Mensch, jetzt hat man vielleicht nicht mehr sein Leben lang den gleichen Job. Okay, das hat sich in den letzten 25 Jahren eh schon geändert, dass man öfter wechseln, was Neues lernen muss und so weiter. Aber die Geschwindigkeit wird halt weiter zunehmen.
Ja, also ich glaube, gerade auch das Thema Weiterbildung wird noch stärker in den Fokus rücken, um eben dranbleiben zu können an den verschiedenen Entwicklungen. Wenn ich halt, ich sage jetzt mal, Tätigkeiten mache, die sehr repetitiv sind, sehr klar regelbasiert, mit einem relativ hohen Volumen passieren, auf klaren Daten, ja, gut, dann wird das zukünftig automatisiert. Ja, das wird passieren.
Frage ist halt: Kommen wir dann in den Bereich, wo wir halt immer ständig kognitiv quasi am Maximum arbeiten müssen? Weil alles, wo wir früher mal so am PC sitzen konnten und mal so eine Stunde lang irgendwie Strg+C, Strg+V gemacht haben, ja, das ist halt jetzt dann weg, ne? Also das ist dann halt immer Highperformance, vielleicht die ganze Zeit, weil ich eben die entsprechenden KI-Systeme dazu habe.
Aber es gibt auch enorme Chancen. Ich meine, wir wollen es mal so sehen: Es ist ja manchmal so das Gespräch: Gibt's da bald die One Billion Dollar Company, die aber nur einen Menschen hat? Okay, das ist vielleicht jetzt zu weit gedacht, ja. Aber nichtsdestotrotz, wenn du heute halt eine Idee hast, kannst du halt mit relativ wenig Ressourceneinsatz sehr, sehr viel schon erreichen.
Du kannst ein Geschäftsmodell aufbauen, du hast Zugriff auf Cloudinfrastrukturen, du kannst Algorithmen nutzen, du hast Zugang zu Plattformen, du kannst viele Dinge automatisieren und kannst mit einem Zwei-, Drei-Mann-Team halt dann vielleicht Dinge tun, wo du vorher halt 20 Mann gebraucht hast. Ja, und dadurch kannst du natürlich auch gut verdienen. Aber vielleicht geht dadurch halt so ein bisschen der Spread auseinander zwischen den Leuten, die halt sehr, sehr gut verdienen, und denen, die halt dann weniger gut verdienen. Ja, das kann durchaus passieren.
Das kann ich mir auch sehr gut vorstellen, dass halt eben die Leute, die jetzt schon irgendwo Highperformer sind, dadurch einfach noch mehr highperformen. Und die, die jetzt vielleicht nicht so stark dabei sind, sich vielleicht davon so ein bisschen unterkriegen lassen und sich eventuell auch nicht weiterentwickeln dahingehend.
37:11Die KI-Basics, die jeder beherrschen sollte
Apropos Weiterentwicklung, auch bezüglich KI: Was würdest du eigentlich so jedem raten, womit er sich auf jeden Fall befassen sollte im Thema KI?
Also, ich glaube, wirklich diese Basics einfach draufzuhaben, im Sinne von: Wie funktioniert denn so ein KI-Modell? Was ist denn vielleicht auch ein Context Window? Also wenn ich da reintippe, dass ich auch weiß, z.B. wenn ich mit einem KI-System in einem Chat bin, dass jedes Mal, wenn ich eine nächste Frage stelle, auch der gesamte Chat wieder indiziert wird. Also, dass ich einfach so ein bisschen die Basics weiß: Ey, wie muss ich mit so einer KI-Software vielleicht kommunizieren?
Ich glaube, Prompting gehört schon auch dazu. Jetzt sagen einige natürlich: Na ja, Prompting-Skills brauchst du vielleicht nicht mehr, weil das übernehmen dann irgendwann Agenten und so. Ja, vielleicht zu einem gewissen Teil schon. Auf der anderen Seite muss ich der KI schon Kontext geben.
Und so ein dümmstes Beispiel dazu ist einfach immer: Wenn ich jetzt zu dir sagen würde: „Meine Oma hat Geburtstag, was soll ich schenken?“ Würdest du sagen: „Ja, tue ich mir jetzt so ein bisschen schwer. Wie alt ist sie denn? Was hat sie für Hobbys? Mag sie vielleicht Musik?“ und so weiter. Ah ja, okay.
Also, wir müssen auch einem KI-Modell, auch wenn es sehr, sehr weiterentwickelt ist, trotzdem wahrscheinlich immer noch einen gewissen Kontext einfach geben, damit es weiß: Ah, okay, es handelt sich um einen, sag ich mal, Managementberater im Bereich Fast Moving Consumer Goods, der macht da irgendwie gerade eine Strategie und so weiter. Ja, also so ein bisschen Kontext muss ich schon geben, damit dann die KI richtig reagieren kann. Das heißt, Machine Communication muss man eigentlich lernen.
Und ein wichtiger Punkt ist natürlich auch, glaube ich: Ich muss mich damit beschäftigen, was es vielleicht auch in meiner Branche bedeutet. Weil manchmal ist es so, ich komme zu Kunden, und die sagen dann: „Ja, Jonas, welches ist denn jetzt der Use Case?“ Sag ich: „Ja, keine Ahnung, weiß ich nicht, kommt drauf an.“ Weil Strom bedeutet halt z.B. für einen Handwerker was anderes als für den Managementberater in seiner täglichen Arbeit, und genauso ist es mit KI auch.
Bin ich im Customer Service, bin ich in der Managementberatung, will ich Angebote erstellen? Also, es kommt halt so ein bisschen drauf an, welche Branche, welche Prozesse wir haben. Und es ist halt eben nicht so dieses Wundertool: egal welcher Use Case, schmeißt, ich sag's mal, ChatGPT drauf, und dann plötzlich „mysteriously it figures it out“. Ja, das passiert eh nicht.
39:29So finden Unternehmen ihre Use Cases
Welche Fragen sollten sich Unternehmen da ganz konkret stellen, um so einen Use Case zu finden?
Also, ich glaube, ein ganz wichtiger Punkt ist natürlich dieses Thema: Wie stark lässt sich so ein Prozess standardisieren? Wie häufig kommt der vor? Habe ich die Daten dazu? Ist es, sage ich mal, regulatorisch auch in Ordnung, wenn ich da KI einsetze? Ist es auch ethisch okay? Ja, das sind, würde ich sagen, so die Basics.
Und dann kommt's aber natürlich auch drauf an: Habe ich in meinem Unternehmen selber die IT-Kompetenz, um das zu machen? Weil häufig, wenn wir über Workflows und sowas reden, dann wollen wir ja Enterprise-Grade AI haben. Das heißt, wir brauchen auch eine gewisse Security. Also muss es, ich sag jetzt mal, in einer europäischen Cloud gehostet werden, und diese Applikation muss dann auch wieder betreut werden und sowas.
Da muss man mal gucken: Wie weit ist man da als Unternehmen schon, und was kann man vielleicht schon, sag ich mal, off the shelf à la SaaS-Solution nutzen? Und ich finde, wo man den Blick als Unternehmen durchaus hinrichten sollte, ist nicht nur, sage ich jetzt mal, auf die Shiny Chat Interfaces, die es da gerade so gibt, à la ChatGPT, Claude, Gemini und so weiter. Sondern durchaus auch zu gucken: Was wird denn an KI-Features implementiert in Salesforce, in HubSpot, in SAP, in Personio, you name it?
Und das hilft mir ja auch, weil z.B., was wir häufig nicht haben, ist eine Workflow-Integration im Sinne von der Mitarbeiterarbeit. Wir haben uns dann irgendwie eine Lösung ausgedacht, dann muss der Mitarbeiter aber erst in das KI-Tool gehen, muss dann mit Strg+C, Strg+V reinkopieren, dann kriegt er ein Ergebnis, dann muss er es wieder rauskopieren und dann muss er es wieder irgendwo anders hinschaufeln. Und dann geht noch das Format verloren und er muss wieder nachformatieren.
Das will er eigentlich gar nicht, sondern er will eigentlich in seiner Umgebung bleiben. Machen wir das Beispiel eines Personalberaters: Der möchte am liebsten in seiner Software-Applikation bleiben. Da führt er das Interview, dann liegt da das Transkript, dann fragt sie: „Okay, soll ich aus dem Transkript jetzt die Job Description machen?“ „Ja, gerne.“ Macht die Job Description, fragt: „Willst du jetzt matchen?“ Und dann zeigt sie mir an: „Hey, die sind gematcht.“ Mach ich nur noch klick, klick, klick.
Also das heißt, ich will eigentlich seamless mit dieser KI interagieren können. Und ich glaube, das wird ein wichtiger Punkt: Wie können wir vielleicht schon AI-Features in Standardsoftware, die da ist, einfach nutzen? Und dann eben, wie gesagt, Prozesse, die sich gut standardisieren lassen.
Also ich sehe immer wieder bei KI, das folgt eigentlich so ein bisschen diesem Konzept, das wir bei Industrie 4.0 hatten: standardisieren, digitalisieren, automatisieren. Ich würde sagen, standardisieren ist relativ klar. Also wenn ich z.B. sage, ich muss jede Woche zweimal einen Research-Prozess, irgendwie eine Wettbewerbsanalyse machen. Ja, okay, gut, dann definiere ich halt genau, wie soll diese Wettbewerbsanalyse aussehen, welche Quellen nehme ich da und so.
Dann definiere ich das einmal, pack das in eine entsprechende Solution rein, und dann kann ich das natürlich immer wiederkehrend ausführen. Und dann brauche ich eben nicht mehr den, sag ich mal, Junior Consultant, der das dann immer wieder macht, sondern ich habe das eben einmal in Software gegossen und kann es dann immer wieder ausführen. Also ich glaube, das ist schon sehr hilfreich.
42:37Wissensmanagement und der eigene KI-Assistent
Ohne irgendwelche kritischen Informationen deinerseits zu nennen: Welche Use Cases hast du vielleicht schon für Unternehmen umgesetzt, von denen man sich einfach inspirieren lassen kann?
Ja, also bei mir ist es häufig im Bereich Knowledge Management, wo es einfach darum geht: Wie können wir den Mitarbeitern Zugriff auf relevante Unternehmensinformationen geben? Weil die Frage ist ja z.B.: Was differenziert mich denn zukünftig noch? Ist es das Modell, das ich einsetze? Nee, eigentlich nicht, weil da hat ja eigentlich jeder Zugriff drauf. Ist es noch der Prompt, den ich schreibe? Ja, das ist wahrscheinlich Mitarbeiterausbildung, Weiterbildung und so.
Aber eigentlich sind es meine proprietären Daten, die mich halt unterscheiden. Und dieser Bereich Knowledge Management, aka „Wenn Siemens wüsste, was Siemens weiß“, aus dem Jahr 2003, das gilt auch noch 22 Jahre später. Genau, also Knowledge Management ist ein ganz wichtiger Case, dann natürlich im Bereich Angebot, Recherche natürlich auch zu Kunden im Vorfeld.
Gleichzeitig aber auch, und das finde ich, ist immer ein schöner Use Case für Mitarbeiter, um sich so ein bisschen zu identifizieren: wenn die wirklich ihren eigenen persönlichen Assistenten erstmal erstellen. Weil dann verstehen die erstmal: Aha, was ist denn ein Prompt und was ist ein Assistent, also quasi ein gepromptetes LLM?
Wo ich reinschreibe: „Hey, ich bin der Jonas Lünendonk, ich bin so und so alt. Mein Schwerpunkt ist das. Wenn der du schreibt, dann schreib du, wenn der Sie schreibt, schreib Sie. Mein Portfolio ist übrigens das hier. Wenn mich da einer anfragt, dann antworte so und so. Hier liegt noch meine Preisliste.“ Also man kann eigentlich einen ganz schönen Personal Assistant und, ich glaube, auch erstmal eine ganz gute Identifikation schaffen.
Genau. Und dann gibt's noch, denke ich, den einen oder anderen Bereich, aber es kommt, wie gesagt, immer so ein bisschen aufs Unternehmen drauf an, wie weit die auch sind, was sie schon machen wollen.
Klar, verstehe ich. KI wird auch aus meiner Sicht irgendwo ein sehr großer Shift sein in dem, wie die Welt halt funktioniert. Also es wird einfach viel passieren dahingehend, und darüber haben wir auch schon irgendwo gesprochen, dass KI auch irgendwo so eine neue Ära einleiten wird. Ist einfach so.
44:47Warum das Tool nur zehn Prozent ausmacht
Wie ist aus deiner Sicht gerade jetzt in diesem Moment die Reife von KI, und wo kommt KI die nächsten Jahre hin?
Ja, also ich glaube, wie sagt man so schön, das ist ja so ein Satz, den man zurzeit öfter liest: „KI war noch nie so dumm wie heute.“ Weil, ich glaube, die Entwicklung, die wir sehen, ist natürlich schon massiv. Also wenn man sich z.B. die Benchmarks anguckt, wie schnell Modelle von, ich sag jetzt mal, GPT-3.5 bis eben jetzt GPT-4.5 oder dann Qwen oder Kimi K2 und so weiter aufholen, in Tests z.B. rund um Mathematik, rund um Logik und so weiter. Und da wirklich gute Ergebnisse liefern, dann ist es schon enorm spannend.
Ich glaube auch, wenn man sieht, wie hoch die Investitionen gerade sind, die in KI fließen, ob das Rechenzentren sind, ob das Chips sind, ob es Algorithmen sind, ob es Investitionen gerade in KI-Forscher sind, die dann teilweise für irgendwie hunderte Millionen abgeworben werden. Wenn da so viel Geld und so viel Effort reingeht, dann wird da sehr, sehr schnell noch mehr passieren.
Und ich glaube, wir sehen ja auch jetzt schon zunehmend, dass es eben spezifischere Lösungen gibt, so à la Research Agents, Angebotsagents, und es geht ja immer weiter. Also ich glaube, wir stehen am Anfang, und die Systeme werden extrem schnell. Ich habe vor ein paar Tagen ein Gespräch mit Eric Schmidt, früher Google, gesehen, der sagte: Na ja, seine Prediction ist so zwischen 3 und 6 Jahren, dass die Systeme wirklich schon selbstdenkend sein können. Das ist natürlich eine Herausforderung für uns.
Verstehe ich.
Aber es wird die Welt von Grund auf verändern, was da passiert. Und das ist, glaube ich, einer der wesentlichen Punkte, die ich in allen Beratungsprojekten gerade sehe. Die Hoffnung zurzeit ist: Kaufe ein Tool à la ChatGPT oder, ich weiß es nicht, schmeiß es auf die Mitarbeiter und wir haben 30 % Effizienzsteigerung. Und das ist einfach nicht das, was passiert.
Also wir sind, würde ich sagen, in diesem Gartner Hype Cycle, den man so kennt, da sind wir bei vielen eben gerade ganz oben am Hype. Und was sich halt immer wieder zeigt: Es geht ganz wesentlich darum, wenn wir im Business-Kontext sind: Wo sind die Daten? Sind die zugänglich? Und sind dann die Mitarbeiter geschult, sind sie ausgebildet dafür? AI ist wirklich, it's the transformation of the service industry.
Und ich glaube, diese Transformation bedarf schon auch eines entsprechenden Change-Prozesses. Und ich glaube, den Mitarbeiter zwei Stunden vor einen Kurs zu setzen und zu sagen: „Jetzt mache ich mal Prompt Engineering mit dem“, und danach kann er das, das funktioniert nicht. Sondern der muss wirklich Erfahrungen machen. Man braucht Communities, wo die Leute zusammenkommen können, Dinge ausprobieren.
Wo auch mein Mitarbeiter sagt: „Hey, übrigens, ich habe mal das und das gemacht, und das hat sehr gut funktioniert.“ Und dann sagt der andere: „Ach, das ist ja interessant, spannend.“ Okay, gut, die müssen voneinander lernen. Weil es so eine neue Technologie ist, brauchen wir diesen Austausch. Und da sehe ich aber schon, dass es oft so ist: Wir fokussieren eben sehr stark erst auf dieses Tool. Wir brauchen das Tool. Ich glaube, der Rattenschwanz hängt so ein bisschen dahinter.
Also, wie sagt man so? Ich glaube, es gibt von der BCG so eine ganz gute Grafik, die sagt so irgendwie: 10 % ist das Tool, 20 % die Daten und 70 % ist Change Management. Ich weiß jetzt nicht, ob es so viel ist, aber es ist schon ein massiver Shift in der Art und Weise, wie wir arbeiten. Jetzt mal ganz ehrlich: Selbst ich, der viel mit KI macht, ertappe mich ja trotzdem dabei, dass ich denke: Ach stimmt, das könnte ich jetzt eigentlich mit KI machen.
Ja, also das geht mir auch ganz oft noch so. Ich glaube, so geht's auch vielen. Viele sehen ja auch z.B. halt eben ChatGPT. Du hast ja gerade eben gesagt: Hey, man macht einen Prompting-Kurs und hat das Thema KI durch. Aber mit ChatGPT ist ja KI nicht durch.
48:38Vernetzte Assistenten und vertikale Lösungen
Was mich noch interessiert, mit Large Language Models im Allgemeinen: Was ist da die Power von ihnen, und was machen da vielleicht Power User mit Large Language Models? Also was ist da alles noch möglich, was wir uns vielleicht noch gar nicht vorstellen können?
Also ich finde das Spannende ja oft, wenn man verschiedene, ich sag es mal, Assistenten miteinander vernetzt, oder vielleicht dann zukünftig wirklich in diese agentic Era. In Teilen gibt es sie schon, aber wenn wir richtig in diese AI Era kommen: Der eine Agent ist so oder so geprompt, der hat Daten zur Verfügung, der erstellt ein Ergebnis, der übergibt dieses Ergebnis zum nächsten Assistant, und dieser nächste Assistant macht wieder was mit dem Ergebnis, iteriert darauf weiter.
Aber da reden wir dann halt oft schon eher nicht von, ich sage jetzt mal, einem einfachen geprompteten GPT, sondern da sind es eher schon Solutions, wo ich halt Dinge bestimmt miteinander verknüpfen muss, mit irgendwelchen Tools, die da irgendwie heißen n8n oder LangGraph und andere.
Aber also, ich will sagen, es kommt extrem drauf an, in welchem Feld, in welchem Bereich wir unterwegs sind. Also wenn wir übers Programmieren reden, dann würde ich sagen, gibt's da Leute, die mit Cursor weit kommen. Oder die sagen: „Mensch, GitHub Copilot, das ist für mich wunderbar. Ich kann dadurch schneller Code schreiben.“ Vielleicht jetzt nicht Software Engineering machen, aber ich kann mir bestimmte Funktionen einfach viel schneller erzeugen lassen, als ich früher konnte.
Wenn wir im Marketingbereich sind, ich meine, klar, dann kannst du natürlich von der Marketingstrategie über die ganzen Assets. Aber das sind dann häufig schon, ich sage jetzt mal, vertikale Lösungen. Ich glaube, das ist eigentlich auch das, wo wir gerade so reinkommen. Wir haben die Chips, wir haben die Data Center, wir haben die Large Language Models, und jetzt sind wir wirklich in der Era, dass wir die Vertical Solutions bauen.
Also dass, sage ich jetzt mal, die eine LLM-Suite vielleicht spezifisch für Personaldienstleister kommt, da sind halt diese ganzen Dinge, diese ganzen geprompteten Assistenten oder vielleicht auch schon Agents drinnen. Genauso für Procurement, genauso für Legal. Warum haben wir denn so viele verschiedene Legal-Startups gerade? Weil es ein sehr spezifisches Feld ist. Da muss ich vielleicht sogar fine-tunen, da muss ich verschiedene Modelle benutzen, verschiedene Daten und so weiter.
Und ich glaube, in die Richtung entwickelt es sich, dass wir wirklich zu dieser Vertikalisierung jetzt kommen mit diesen KI-Solutions. Aber deswegen sage ich auch zu den Unternehmen: Nutzt die Zeit jetzt, um eure Mitarbeiter in den Basics auszubilden, um allen Mitarbeitern zumindest schon mal Zugang zu einem Large Language Model zu geben, das in einer sicheren, complianten Umgebung zur Verfügung steht, dass die sich ausprobieren können, und macht eure Use Cases.
Und wenn da welche dabei sind, die man sehr, sehr schnell umsetzen kann, wunderbar, dann wird es gemacht. Aber bei einigen ist es halt so, die brauchen ja noch ein bisschen länger.
Verstehe.
51:53Halluzinationen erkennen und vermeiden
Wir haben ja auch mal in unserem Vorgespräch über das Thema Halluzinieren gesprochen. Die KI kann ja auch halluzinieren. Und für alle, die das nicht kennen: Das ist im Endeffekt, wenn man der KI einen Prompt gibt und die KI einem Daten zurückgibt, die eigentlich komplett unbrauchbar sind. Dass man sie z.B. fragt: „Hey, gib mir bitte Links für X und Z.“ Sie gibt Links zurück, aber sie funktionieren am Ende nicht.
Mit KI, und wenn man verschiedene Dinge promptet, umsetzt etc.: Wo müssen wir vielleicht noch aufpassen? Also was gibt es da noch generell zu beachten, sei es beim Halluzinieren oder bei anderen Dingen auch?
Ja, ich glaube, wenn man jetzt erstmal vielleicht nur das Wissen benutzt, das in das Large Language Model sowieso schon reintrainiert wurde, dann kann man sich das, glaube ich, schon so ein bisschen sinnbildlich vorstellen: Umso verbreiteter das Wissen wahrscheinlich ist, umso sicherer ist es, dass ich die gute Information kriege. Umso nischiger das Wissen wird, umso höher ist natürlich auch die Wahrscheinlichkeit, dass ich irgendwie eine Halluzination bekomme.
Weil das Modell vielleicht etwas nicht weiß und dann entsprechend eine Antwort basierend auf Tokens produziert, und dass es dann vielleicht eben in eine falsche Richtung abbiegt und mir dann eine Lösung präsentiert, die zwar textlich gut klingt, aber inhaltlich nicht stimmt.
Ich glaube, ein anderes Problem ist dann noch mal dieses Thema: Wir machen Websearch mit Large Language Models, „Such mir mal im Internet“, und dass dann die Systematik dahinter manchmal noch nicht so gut funktioniert. Dass es die Information, die es dann findet, auch so brauchbar wieder zusammensetzt und uns auch die entsprechenden Links gibt, die auch wirklich funktionieren. Da gibt's durchaus noch Probleme.
Also ich glaube, es gibt so Studien zu Perplexity und anderen, da sind, glaube ich, so 30 % der Infos oder der Links teilweise nicht funktionierend, oder es steht dann auf der Webseite doch wieder ein bisschen was anderes als das, was die KI dann als Zusammenfassung erzeugt hat.
Aber nichtsdestotrotz, ich glaube, man muss sich klar sein, dass es Halluzinationen gibt. Aber deswegen sollte man auch immer, würde ich sagen, das Fachwissen haben, um eine KI-Antwort beurteilen zu können. Wenn ich fachlich nicht in der Lage bin zu beurteilen, was die KI mir da jetzt gerade als Ergebnis geliefert hat, dann bin ich halt auf dünnem Eis. Weil dann ist quasi mein Praktikant schlauer als ich, und das ist ein bisschen schwierig.
Aber ich würde sagen, in der Regel kann man Halluzinationen, wenn man darauf aufpasst, in den Griff kriegen. Und vor allem, wenn man mit Unternehmensdaten arbeitet, kann man ja durchaus die Antworten auch, wie man so schön sagt, im Unternehmenswissen grounden. Das funktioniert schon auch ganz gut, aber nichtsdestotrotz ist es ein Thema, wo wir immer drauf aufpassen müssen.
Klar. Viele nutzen ja auch z.B. KI, um irgendwelche Skripte zu erstellen oder um irgendwo irgendwelche Befehle zu erstellen, und das finde ich dann schon irgendwo ein bisschen fahrlässig, sage ich mal. Da kann ja im Endeffekt alles passieren, wenn man z.B. einen Code erstellen lässt, der dann irgendwo irgendwas verschiebt oder löscht oder was weiß ich was, selbst aber keine Ahnung vom Programmieren hat. Dann kann auch einfach sehr viel schiefgehen.
Ja, das stimmt. Was ich aber in dem Zusammenhang vielleicht spannend fand: Es gibt eine Studie, da haben die z.B. einen Assistenten geprompt und gesagt: „Okay, du bist Senior Software Developer, du kennst dich besonders gut mit Thema XY aus. Und du schreibst dann eben die entsprechenden Funktionen, je nachdem, was wir halt anfragen.“
Und dann nimmt man das Ergebnis, das er produziert, und schickt es einfach in den nächsten geprompteten Assistenten rein, und dem sagt man: „Okay, du bist Experte für Software Engineering im Hinblick auf Security, Scalability und weißt auch, dass man bestimmte Libraries bei uns nicht verwenden darf.“ Und dann validiert er quasi das Ergebnis und verbessert es.
Und allein dadurch kriege ich schon ein deutlich besseres Ergebnis raus. Also irgendwie von 45 % springt die Qualität dann auf fast 75 %. Nur weil ich zwei gepromptete LLMs nehme und sage: Okay, der ist Judge, wenn man so will. Das Ergebnis, das da rauskommt, lass ich noch mal vom nächsten beurteilen und verbessern.
Auch spannend. Ja, coole Sichtweise.
56:10Wo KI schon glänzt und wo sie an Grenzen stößt
In welchen Bereichen funktioniert KI deiner Meinung nach schon sehr gut, und wo eher weniger, also wo vielleicht noch gar nicht?
Also ich glaube, wo es sehr gut funktioniert, deswegen heißen die Dinger, glaube ich, auch Large Language Models, ist halt alles, was irgendwo mit Sprache zu tun hat. Da sind sie gut. Ich würde sagen, im Bereich Sales sind die ordentlich gut unterwegs, im Bereich Marketing. Deswegen ist es auch nicht überraschend, dass Unternehmen wie HubSpot oder Salesforce natürlich da stark drauf setzen.
Dann natürlich im Bereich Customer Service. Also ich glaube, Customer Service ist das Feld: Wenn man jetzt klassischer Customer Service Agent ist und Telefonanrufe beantwortet, das wird sich massiv verändern. Ich glaube, da funktioniert es schon sehr, sehr gut, und da ist es auch schon recht weit.
Da kommen dann z.B. so Sachen, also Salesforce hat, glaube ich, Agentforce, wo die sagen, sie haben Agenten, oder auch z.B. so Plattformen wie ServiceNow im Sinne von vielleicht auch IT Service Management. Ich glaube, da funktionieren diese Large Language Models schon sehr gut, weil, wie gesagt, wir sind auf Text unterwegs. Wir haben auch viele Daten, auf denen sie lernen konnten. Da sind sie schon sehr, sehr gut. Ja, genau.
Gibt's auch Bereiche, wo du sagst, dass eine KI das vielleicht nie ersetzen kann?
Ach so, ja, einen Bereich habe ich noch vergessen. Also ich glaube, es ist auch so ein Bereich wie Psychologie, ohne jetzt zu sagen, dass das ein Psychiater ist. Also nein, ist es nicht, natürlich nicht. Aber im Hinblick darauf, z.B. zu sagen: „Hey, ich habe da vielleicht einen Konflikt, und das ist passiert, und meine Sicht ist die, aber wie könnte denn vielleicht noch eine andere Sicht drauf sein?“ Das ist durchaus interessant.
Also ich mache das ja doch manchmal und finde schon interessant, was da wieder für Aspekte kommen, wo ich mir so denke: Da hast du jetzt eigentlich gar nicht drüber nachgedacht, aber ist eine interessante Sichtweise. Also ich meine, Psychologie und so weiter beruht ja auch stark auf Text.
Wo wird es das vielleicht am ehesten noch gar nicht ersetzen können? Also ich glaube, dieser Traum: „Hey, wir machen jetzt ganze Hollywood-Filme damit“, glaube ich jetzt nicht. Ich glaube, das ist schwierig. Es ist aber so, dass bei kurzen, ich sag jetzt mal, Clips, Werbeclips und so, im Sekunden-, Minutenbereich, da wird KI relativ zügig, würde ich sagen, oder findet schon einen Zug.
Wo könnte man es gar nicht, ne? Ich glaube, dieses Thema vielleicht auch menschliche Interaktion. Aber auf der anderen Seite, ich sage es mal so, ich finde ja auch, KI kann schon auch ganz gut simulieren. Also es gab jetzt z.B. vor zwei, drei Monaten einen Bericht darüber, dass die Universität Zürich auf Reddit Bots geschaltet hatte, die quasi deine Posts analysiert haben und dann versucht haben, dich eben von einer anderen Meinung zu überzeugen.
Und die waren irgendwie in 40 bis 50 % der Fälle erfolgreich und haben die Leute dann von einer anderen Meinung überzeugt, weil sie sie manipuliert haben. Das heißt, das Thema Menschenführung und so weiter kann ja doch durchaus auch durch KI, also ich sag's mal, eine vielleicht nicht so gute Führungskraft kann ja durch KI doch durchaus zu einer augmentierten guten Führungskraft werden, weil sie halt KI einsetzt.
Ich sehe noch nicht so die Limits gerade, glaube ich. Weil es dringt halt extrem in dieses kognitive Feld ein. Und ja, den Handwerker wird's aber noch nicht ersetzen. Na ja, genau.
59:56Agenten: echtes Potenzial oder nur Hype?
Gut. Wofür sind Agenten deiner Meinung nach gut und wo ist der Hype vielleicht einfach nur zu krass, also zu aufgeblasen?
Na ja, ich glaube, wir können halt in der Breite der Gesellschaft noch nicht mal irgendwie prompten oder verstehen KI und haben auch unsere Daten nicht darauf vorbereitet und wollen halt jetzt schon wie der Teufel Agenten machen. Warum gibt's denn Agenten in so Systemen wie ServiceNow, wie Salesforce und so weiter? Na ja, weil das geschlossene Systeme sind. Und das sind auch Prozesse, ich sage jetzt mal im Marketing oder im Service Management, die wahrscheinlich industrieübergreifend auch relativ ähnlich sind. Da muss ich nicht so viel anpassen.
Wenn ich für mich selber Agenten natürlich erstellen will oder das bauen will, ja, dann muss ich mir halt überlegen: Welche Prozesse, wir sind wieder bei den Prozessen, sorry, sind einigermaßen standardisierbar, sind einigermaßen nachvollziehbar und wo habe ich auch die Daten dazu? Und habe ich dann auch das Entwicklungs- und Betriebs-Know-how in meinem Unternehmen, um das zu machen?
Aber natürlich ist es hochspannend, weil: Was ist denn eigentlich der Gamechanger, der aus meiner Sicht durch KI passiert? Wir sehen ja eine Technologisierung der Dienstleistung. Und es heißt plötzlich: Einen Service wie Bildbearbeitung, Bildkreation kann ich plötzlich mit einem Tool wie Midjourney machen.
Und warum hat denn Midjourney, die, ich glaube, nach meinen Infos so zwischen 40 und 100 Mitarbeiter haben, irgendwie aber eine deutliche Milliardenbewertung? Warum hat denn so ein kleines Unternehmen so eine große Bewertung? Na ja, weil die eben diesen Prozess, der da heißt Bildbearbeitung, Bildkreation, wo wir Hunderttausende von Menschen da draußen hatten, die das gemacht haben, halt ersetzt haben. Und ich mache jetzt eben nicht mehr Software as a Service, sondern plötzlich Service as a Software.
Ich kaufe mir einen Dienstleistungsservice auf Basis einer Software ein, die da heißt Midjourney, die da heißt ElevenLabs für Audio, die da heißt Cursor für Software. Und das macht das natürlich spannend. Aber dann ist die Frage halt: Ist es dann „The winner takes it all“? Weil du willst ja das beste Modell verwenden, dann hast du entsprechende Konzentrationseffekte.
Aber ja, also diese agentischen Systeme werden spannend. Und natürlich, umso mehr ich halt ein Industrie- oder auch ein Department-, also wie soll ich sagen, Bereichs- oder Industrie-Know-how habe, umso besser kann ich natürlich dann auch Agenten entwickeln, umso mehr Agenten kann ich in meiner Plattform implementieren und umso einfacher ist es z.B. für die Mitarbeiter, dann eben darauf zuzugreifen.
Also auch hier wieder Thema Prozesse: Da absolut klar sein, gute Daten haben und dann kann man mit Agenten noch viel mehr anfangen.
Dann kann man noch, also ich meine, man kann schon heute auch die eine oder andere Geschichte machen. Aber die Frage ist natürlich halt: Wenn ich jetzt einen Agent habe, der unter anderem vielleicht kurz auf Unternehmenswissen zugreifen muss, aber das ist nicht da, ja gut, dann wird's eben schwierig.
Oder ich rede viel mit Dienstleistungsunternehmen. Dienstleistungsunternehmen haben in der Regel jetzt nicht wie Industrieunternehmen schon seit 10, 15 Jahren eine Data-Analytics-Einheit, sondern Dienstleistungsunternehmen haben in der Regel ein paar Leute in der IT, die halt Desktop-Administration machen. Dass die Server, also das waren früher noch Server, jetzt dann langsam halt Cloud, dass das alles irgendwie in der Cloud läuft, dass halt die Geräte laufen, dass die da richtig eingebunden sind in die Domain und so weiter.
Aber was die halt nicht haben, ist die Cloud-Expertise im Sinne von: Hey, wie kann ich denn in Azure oder in AWS oder in Gemini oder anderen Tools schnell eben KI-Lösungen aufsetzen? Sicher, skalierbar auch, die ich warten muss, die ich auch überwachen muss, weil dann irgendwie vielleicht falsche Daten angezogen werden, dann ständig Probleme auftreten. Und da brauche ich natürlich einfach eine andere Infrastruktur.
Deswegen gehe ich davon aus, dass die Tech-Investments auch von Dienstleistungsgesellschaften, Stichwort Technologisierung der Dienstleistung, deutlich steigen müssen in den kommenden Jahren.
1:04:12Die häufigsten Fehler im Umgang mit KI
Was machen Menschen im Zusammenhang mit KI noch falsch? Wo schüttelst du vielleicht noch ganz besonders den Kopf?
Wenn das, was eine KI produziert, als Wahrheit angenommen wird. Das finde ich schon sehr bedenklich, so im Sinne von: „Ja, aber das hat doch ChatGPT gesagt.“ Das ist schon nicht gut. Also ja, weil, wie gesagt, wenn wir da in den Bereich kommen, wo ich das Ergebnis, das die KI produziert, fachlich nicht beurteilen kann, dann begebe ich mich halt eben aufs Glatteis.
Und ich hatte z.B. neulich einen Kollegen, der hat gesagt: „Mensch, ich hab mir ein Angebot machen lassen für irgendwie eine Hausrenovierung. Und dann habe ich das mit ChatGPT o3 gemacht und habe den da beschrieben und dann kam irgendwie raus, das hat irgendwie 100.000 € kosten.“ Und dann hat er gesagt: „Ich habe aber das richtige Angebot gehabt von meinem Handwerker und es waren irgendwie 125.000 €.“
Dann hat er gesagt: „Ja, und dann habe ich der KI gesagt: Aber ich wohne ja in München. Und dann hat die KI gesagt: Ja klar, da muss es natürlich viel teurer sein.“ Und dann war der Preis also so. Und dann sagt der Mensch, also, das hat die dann auch verstanden.
Aber das Problem ist: Ich liefere ihr eigentlich die Vorlage, das ist eine Self-fulfilling Prophecy an der Stelle. Also ich gebe ja schon die Vorlage fürs Argument, dass es teurer sein muss, weil sie ja anscheinend auch aus Dokumenten lernt, dass Lebenshaltungskosten in München irgendwie höher und wahrscheinlich auch Dienstleistungen teurer sind. Genau. Ich glaube, da muss man einfach so ein bisschen aufpassen, wenn ich halt eben fachlich nicht beurteilen kann, ob ich das dann für voll nehme.
Und natürlich auch so dieser Punkt wie im Internet, ne? Also ja, im Internet, das merkt keiner, was ich da mache, und sieht ja eh niemand. Ich glaube, auch so dieses: Ich gebe meine Daten einfach eben in Tools wie ChatGPT und andere oder hier Meta AI for free rein. Da würde ich schon ein bisschen zurückhaltender sein. Also, ich glaube, das kann durchaus schon eine Gefahr zukünftig sein.
Neben diesen zwei Punkten, was machen Menschen vielleicht in der Nutzung von KI falsch? Also, keine Ahnung, vielleicht beim Prompting, vielleicht bei den Daten, die sie haben, etc.
Ich glaube, es wird zurzeit zu viel erwartet. KI ist oft so diese Magic Box, wo man sagt: „Hey, brauchen wir noch Data Management? Also wir können doch all die Daten geben und das macht dann die KI.“ Nee, passiert eben nicht. Ja, also ich glaube, man traut KI zu viel zu oder hat zu hohe Erwartungen.
Dann vielleicht auch im Thema Prompting, was interessant ist. Ja, jeder weiß mittlerweile irgendwie, glaube ich, dass man irgendwie eine Rolle geben muss oder sollte: Ja, „du bist ein“ oder „verhalte dich als“ und so weiter. Ich glaube, was oft eben noch nicht gemacht wird, ist dieses: Wie gebe ich denn wirklich strukturiert jetzt den Kontext eigentlich zu dieser Aufgabe?
Und ich glaube, das ist sehr, sehr hilfreich, wenn man das macht. Wenn man sich halt auch überlegt: Was für einen Output will ich, welches Ergebnis möchte ich überhaupt haben? Will ich wieder so eine komische Auflistung haben? Will ich eigentlich eine Tabelle haben? Und wie genau muss ich mein Endergebnis eigentlich beschreiben?
Also, wenn man z.B. dann jemandem sagt: Mensch, ja, okay, du möchtest aus diesen ganzen Informationen eine PowerPoint-Präsentation machen mit 15 Folien. Ja, dann schreib doch: 15 Folien, sag mir eine Headline und eine Subheadline und auf jeder Folie soll so und so viel Text drauf sein, und gib mir das so aus. Gut, jetzt erstellt er aktuell noch keine Folien, aber kann er ja bald. Aber ich kriege zumindest den ganzen Content dafür. Also gerade diese Outputsteuerung, glaube ich, ist noch sehr wichtig.
Und dann ist natürlich so dieses, wie soll ich sagen, dass man halt Large Language Models oft als einfaches Websearch-Tool sieht. Ja, die sind da schon ganz gut. Aber ich glaube, manchmal ist es auch ganz gut, trotzdem noch mal nebenbei ein bisschen zu googeln und zu gucken, ob man vielleicht noch mal auf andere Ergebnisse kommt. Aber ja, definitiv.
Danke fürs Teilen. Sehr spannend alles.
1:08:09Woran Jonas arbeitet und wo du ihn findest
Woran arbeitest du aktuell und wo findet man dich, wenn man mit dir in Kontakt kommen mag?
Ja, also man findet mich auf LinkedIn, ganz, ganz einfach. Woran arbeite ich? Ja, ich mache maßgeblich KI-Strategien für Professional-Services-Unternehmen. Das heißt, ich bin jetzt nicht der, der das Large Language Model irgendwie noch auf die letzte Stufe trainiert, sondern ich bin eigentlich die Brücke zwischen Data Science auf der einen Seite und Business auf der anderen.
Und ich entwickle gemeinsam mit Unternehmen wirklich eine ganz klare Schritt-für-Schritt-Roadmap, um zum AI-augmented Unternehmen zu kommen und die Basis dafür zu legen. Das beinhaltet natürlich so Dinge wie Training, Schulung, Guidelines, Use-Case-Entwicklung, aber natürlich auch das Zusammenziehen von technischen Partnern. Das heißt vielleicht Experten für SharePoint, die man braucht, Experten für Azure, ja, um dann je nach Anwendungsfall die richtigen Use Cases umzusetzen.
Und was ich natürlich auch sehr oft mache, sind ganz klassisch Vorträge.
Vielen Dank fürs Teilen. Danke auch für dein ganzes Wissen und ansonsten dir einen wunderschönen Tag.
Ja, vielen Dank. Danke schön. Ciao.
Ciao.
Ich hoffe, dir hat der Podcast mit Jonas so sehr gefallen wie mir das Gespräch mit Jonas und du konntest einiges für dich mitnehmen. Ich würde mich sehr freuen, damit hier auch immer mehr und mehr tolle Gäste reinkommen, wenn du mir einen Kommentar dalassen würdest, hier auf YouTube oder auf Spotify. Einfach in die Kommentare gehen und vielleicht auch mal einfach „Roboter“ reinschreiben. Würde mich sehr freuen.
Falls du jemanden kennst, der perfekt für den Podcast geeignet wäre, dann schreib den Namen gerne in die Kommentare und schreib die Person an, ob sie Lust hätte, dabei zu sein. Genau. Und ansonsten wünsche ich dir noch einen wunderschönen Tag. Vielen Dank fürs Zuhören und bis dann.
Ich brauche eine Website, die mir qualifizierte Leads bringt!
